英伟达 129 亿买下开源模型的默认入口
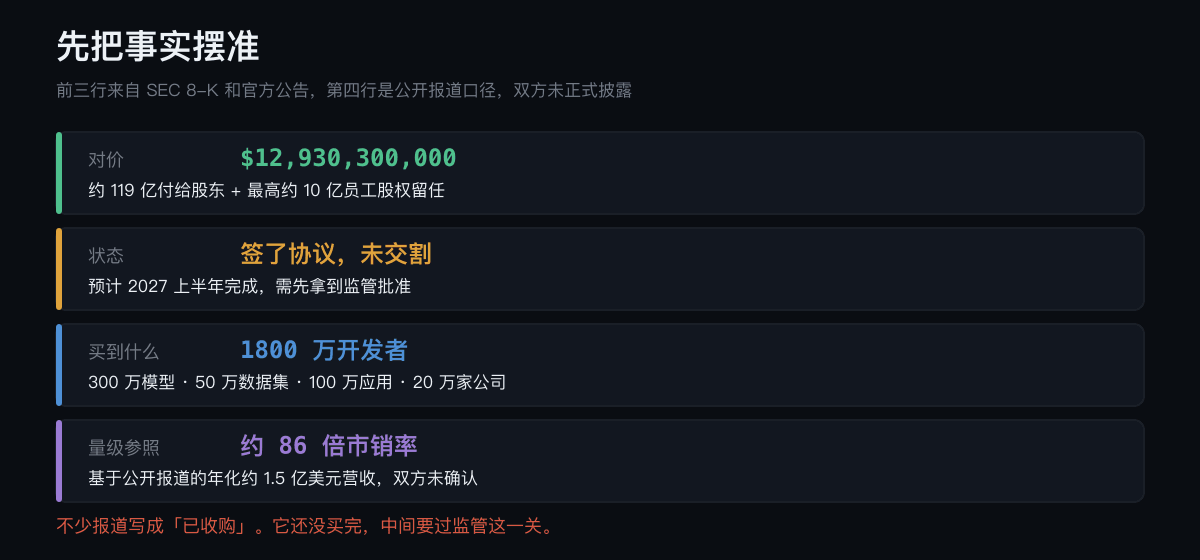
9 月 2 日英伟达跟 Hugging Face 签了最终协议,对价 129.303 亿美元,其中约 119 亿付给股东、最高约 10 亿是员工股权留任。先说清楚一个容易搞错的地方:这笔交易还没完成,8-K 里写的是预计 2027 年上半年交割,还要过监管。按公开报道的营收口径推算,这个价格大约相当于 86 倍市销率,显然不是按收入定的价。黄仁勋承诺不会要求开发者必须使用英伟达算力,这个承诺用的词是 required,它约束的是强制,不约束默认:模型页面上的示例代码、部署按钮指向哪个后端、benchmark 在哪块卡上跑,这些才是 129 亿买到的东西。而该平台自己的数据显示,下载量前 200 的模型占了全平台 49.6% 的下载,想影响分发根本不需要碰那 300 万个模型。
9 月 2 日,英伟达跟 Hugging Face 签了最终协议,对价 129.303 亿美元。第二天黄仁勋在官方博客上公布了这件事。
先把一个容易搞错的地方说清楚:这笔交易还没完成。8-K 文件里写的是预计 2027 年上半年交割,前提是拿到必要的监管批准。现在的状态是签了协议,不是买完了。
价格结构也在文件里:约 119 亿美元付给 Hugging Face 股东,另有最高约 10 亿美元的股权留任计划,给加入英伟达的 Hugging Face 员工。
这是英伟达历史上第二大的收购。
我想聊的是另一件事:129 亿买的到底是什么,以及这笔钱会怎么改变开发者每天接触的那个界面。
一、这个价格买的不是收入
Hugging Face 从来没正式披露过营收规模。公开报道里流传的数字是年化一亿五千万美元上下,双方都没确认过,所以下面这个算术只能当参考:129 亿对一亿五,大概是 86 倍市销率。
就算这个数字不准,量级是清楚的。这个价格跟收入没什么关系。
按官方博客的口径,这个平台上有 1800 万开发者、研究者和创作者,300 万个模型,50 万个数据集,100 万个应用,20 万多家公司在用。
英伟达买的是这个位置。
具体点说:当今天全世界的开源模型要发出来的时候,它们默认发在哪儿;当一个开发者要找模型、下模型、试模型的时候,他默认打开哪个页面。
这个位置以前是没有主人的。现在有了。
二、去年它拒绝过英伟达
有个细节值得放在一起看。
据公开报道,Hugging Face 去年拒绝过英伟达约 5 亿美元的投资要约,对应估值约 70 亿,拒绝的理由是担心控股投资会损害它的中立性。这条同样没有官方确认。
今年它的 CEO 公开说,是自己主动联系的黄仁勋。
从拒绝到主动,中间隔了一年。
我的判断是,这一年里变的是账。
Hugging Face 承担的是一个公共基础设施的角色:全世界的开源模型在这儿发布、存储、分发,权重文件动辄几十上百 GB,带宽和存储成本随着模型体量一起涨。但它的收入结构撑不起这个角色,一亿多美元的年收入(如果那个数字大致对的话)跟它承担的流量量级完全不匹配。
中立是有成本的,而且这个成本一直在涨。去年它还付得起,今年付不起了。
这件事本身比谁买了它更值得注意。
三、承诺管得住「强制」,管不住「默认」
黄仁勋在公告里给了明确承诺,原文是:
Developers will choose the models they want, the frameworks they want, the clouds and inference service providers they want and the computing platforms they want. NVIDIA compute will not be required to build on or deploy through Hugging Face.
翻过来就是:开发者想用什么模型、什么框架、什么云和推理服务商、什么计算平台,都自己选。在 Hugging Face 上构建或部署,不会被要求必须使用英伟达的算力。
这个承诺我认为是真的,也不难遵守。
因为控制分发入口的价值,从来就不在「强制」上。
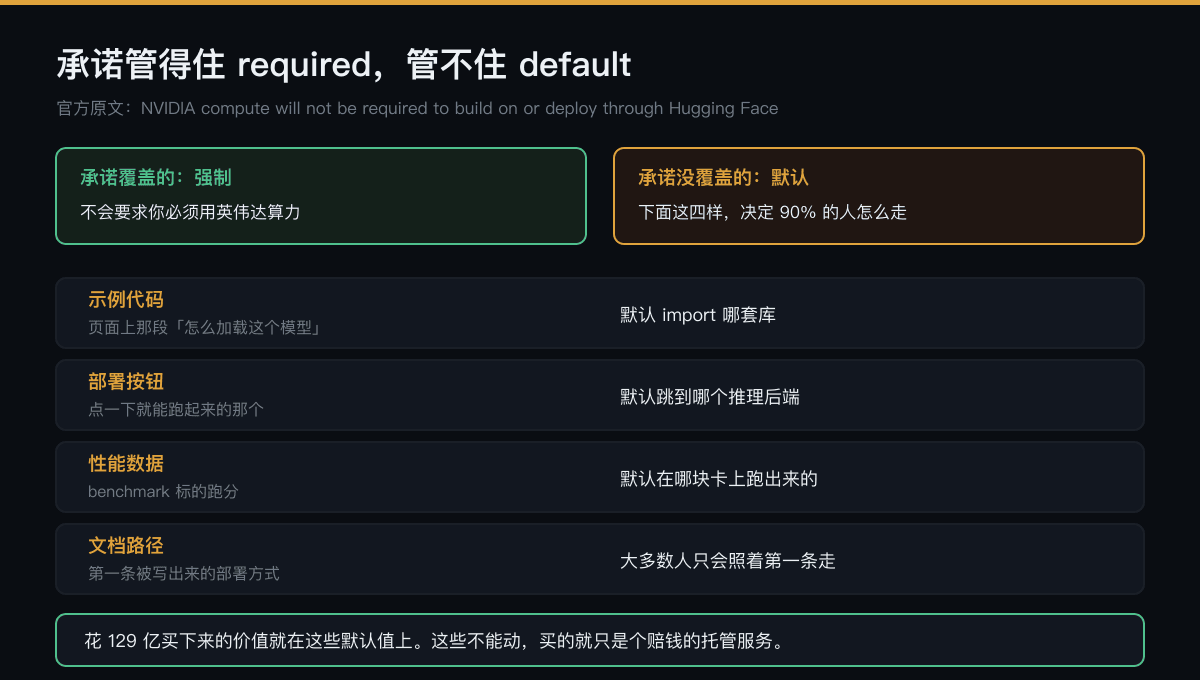
想想你自己是怎么用这个平台的。你搜到一个模型,打开它的页面,页面上有:
一段示例代码,告诉你怎么加载它。 一个部署按钮,点了之后跳到某个推理服务。 一份性能数据,标着在什么硬件上跑出来的。 一串安装命令,装的是某一套工具链。
这些东西没有一个带「强制」二字。但它们决定了绝大多数人的第一次尝试走哪条路。而第一次走通的那条路,多数人就一直走下去了。
示例代码里默认导入哪个库,部署按钮默认指向哪个后端,benchmark 默认在哪块卡上跑,文档里第一个出现的是哪条部署路径。这些全是默认值,全不在「required」那句承诺的约束范围内。
英伟达不一定会这么干。但要看到,花 129 亿买下来的东西,价值就在这些默认值上。如果这些默认值不能动,那这笔钱买的就只是一个赔钱的托管服务。
所以该盯的是往后两年这些默认值有没有变化,盯承诺没用。这件事开发者自己就能观察到,不需要等谁来公布。
四、要影响分发,不需要碰 300 万个模型
这个平台的生态结构有个特征,很多人没注意到。
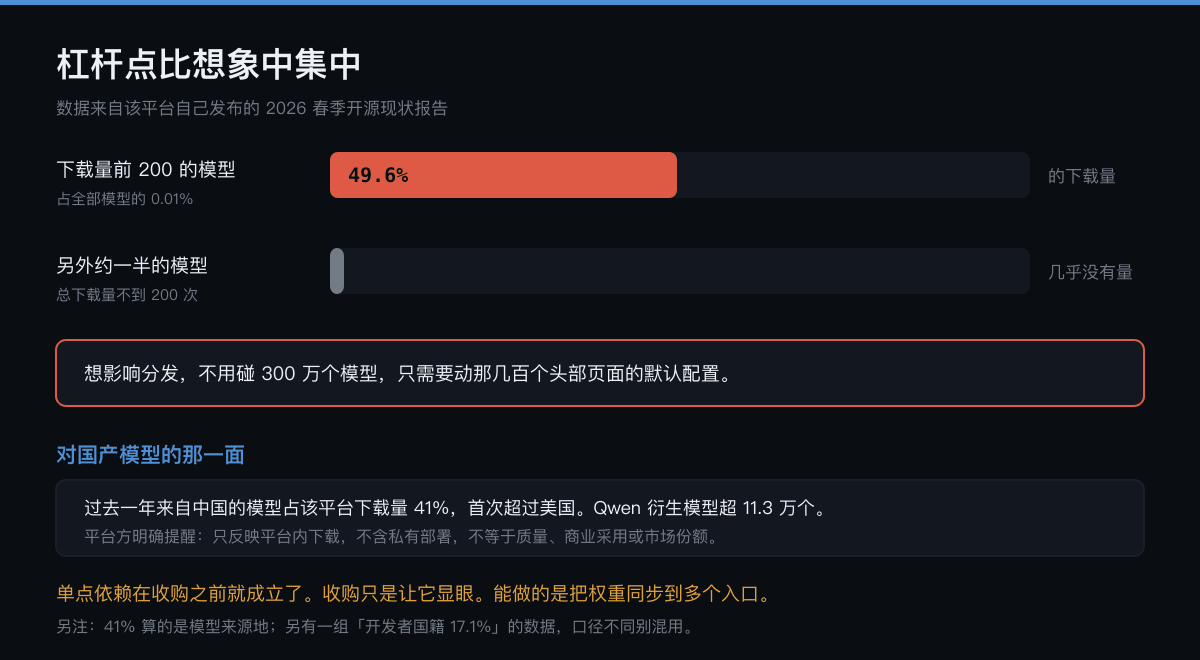
按 Hugging Face 自己在 2026 年春季那份开源现状报告里的数据:下载量排名前 200 的模型,占了全平台下载量的 49.6%。而这 200 个模型只占平台全部模型的 0.01%。
同一份报告里还有一条:大约一半的模型,总下载量不到 200 次。
这是个极度头部集中的分布。
它的含义是:想影响这个生态里的模型分发,不需要动 300 万个模型,只需要影响那几百个头部模型的页面默认配置。这件事的工作量小到可以忽略不计。
这也解释了为什么这个位置值 129 亿。杠杆率太高了。
五、对国产开源模型意味着什么
同一份报告里还有一个数字,对国内做模型的人更直接:过去一年,来自中国的模型占了该平台下载量的 41%,首次超过美国。
另外,阿里 Qwen 系列的衍生模型超过 11.3 万个,比 Google 和 Meta 加起来还多;带 Qwen 标签的模型总数超过 20 万。
这两个数字得配着 Hugging Face 自己给的提醒一起看。他们在报告里明确说了:这只衡量该平台上的下载行为,不包含私有部署,不代表商业采用,也不能当成模型质量或市场份额的直接指标。而且 41% 算的是模型的来源地,另有一组「中国开发者占下载 17.1%」的数据算的是开发者国籍,两个口径完全不同,经常被混着引用。
抛开口径问题,有个结构性事实是成立的:国产开源模型的海外分发,高度集中在一个平台上。
我想强调的是,这件事在这笔收购之前就已经是这样了。收购没有制造这个风险,只是让它变得显眼。
这是个技术层面的单点依赖问题,跟买家是谁关系不大。换个买家,或者不卖,依赖度也是一样的。
对做模型的团队,能做的事情很具体:权重同步发到多个平台,别只推一个入口;国内的镜像和平台保持更新,不要等海外渠道出问题再补;如果有企业客户依赖你的模型,给他们一份不经过该平台的获取方式。
这些事情做起来成本不高,而且不管这笔交易最后批不批,做了都不亏。
六、这不是第一次,也不会是最后一次
开发者依赖的基础设施被商业公司买走,这事有过好几轮了。代码托管、包管理、镜像仓库,路径都类似:一个项目从社区里长出来,成为大家默认使用的公共设施,然后发现自己的收入撑不起这个规模,最后被一家有钱的公司接手。
每一次收购宣布的时候,承诺都是「保持开放」。
也确实大多保持了开放。变的是默认值、是优先级、是那些不写在公告里的东西:哪个功能先做,哪个集成排在前面,哪类用户的需求先被满足。
我的判断是,这类基础设施的商业化是结构性的,跟哪一家公司接手关系不大。只要它的成本曲线和收入曲线对不上,早晚会有这一天。
要公平地说一句:如果没有这笔钱,Hugging Face 能不能撑住现在这个规模,本身是个问题。开源生态的存储和带宽不是免费的,总得有人付。这跟担心中立性被削弱,是同时成立的两件事。
七、往后看什么
监管审批。预计 2027 年上半年交割,中间要过监管。一家在 AI 算力上有绝对份额的公司,去收购开源模型最主要的分发平台,审查不会简单。这一步现在还没答案。
默认值。上面说过了,这是最该盯的。示例代码、部署入口、推理后端、benchmark 硬件,这几样任何一样开始向单一方向倾斜,都比公告里的措辞更能说明问题。
开发者会不会用脚投票。把人留住的是习惯和网络效应,技术上并没有壁垒。真要迁移,技术上没那么难,难的是所有人一起迁。所以短期内大概率什么都不会发生,长期看取决于前面那一条。
其他平台会不会补位。头部集中意味着替代品的门槛其实不高,只要能把那几百个头部模型的同步做好,就有机会承接一部分分发需求。
最后
129 亿美元,86 倍市销率(如果那个营收数字大致成立的话),买的是全世界开源模型的默认入口。
这个价格在传统财务框架里说不通,在分发权的框架里说得通。
而对每天用这个平台的人来说,交割那天不会有任何感觉。变化会发生在某次改版之后:你发现示例代码里那行 import 换了,或者那个部署按钮跳去了别的地方。
那才是 129 亿开始生效的时刻。
几句边界
交易金额、协议签署日、交割时间、对价结构,来自英伟达向 SEC 提交的 8-K 文件和官方博客公告。交易尚未完成,仍需监管批准。
Hugging Face 的营收规模、去年拒绝英伟达投资这两条,来自公开报道,双方均未正式披露,文中据此做的市销率计算只能当量级参考。
生态数据来自 Hugging Face 自己发布的开源现状报告,该报告明确说明这些数字只反映平台内的活动,不能直接当作模型质量、商业采用或市场份额的衡量。
平台规模数字按官方公告口径,跟报告口径因时间点不同略有差异。