免费大模型,谁跟得住指令,谁自己发挥
前面几篇一直在测这批免费入口能不能调通、快不快、额度够不够,但「能调通」和「能拿来干活」中间还差一截。今天出了四道硬指令题,判定全是机器可判的标准:只输出 JSON、只输出数字、正好 10 个汉字、不知道就只说我不知道。结果三道题大家基本都会,卡住的是同一道:让它正好给 10 个汉字,智谱给了 6 个、NVIDIA 给了 12 个,共同短板不在理解在数数。另外还有两个坑比排名有用,一个是 thinking 模型输出额度给少了会返回空、看着像完全不听指令,一个是 Kimi 只接受 temperature=1。
前面几篇我一直在测这批免费入口能不能调通、快不快、额度够不够。但「能调通」和「能拿来干活」中间还差一截。
今天测的是指令遵循:你让它干什么,它照做没有。
出了四道题,判定标准全是机器能判的硬标准,不掺我的主观感受。每家每题跑三次。
结果有点意外:三道题大家基本都会,卡住的是同一道。
四道题
只输出 JSON。给一句话让它提取人名和城市,明确说了只输出 JSON、不要解释、不要 markdown 代码块。判定是 JSON.parse 能不能过,外面有没有套 ```。
只输出数字。问 13 乘 17,要求只输出数字本身。判定是输出严格等于 221,多一个字都不算过。
严格字数。用且仅用 10 个汉字解释什么是缓存。判定是数一下汉字,正好 10 个才算过。
承认不知道。问它一个不可能知道的数字,明确说不知道就只回四个字「我不知道」。判定是有没有「我不知道」,以及有没有硬编一个数出来。
结果
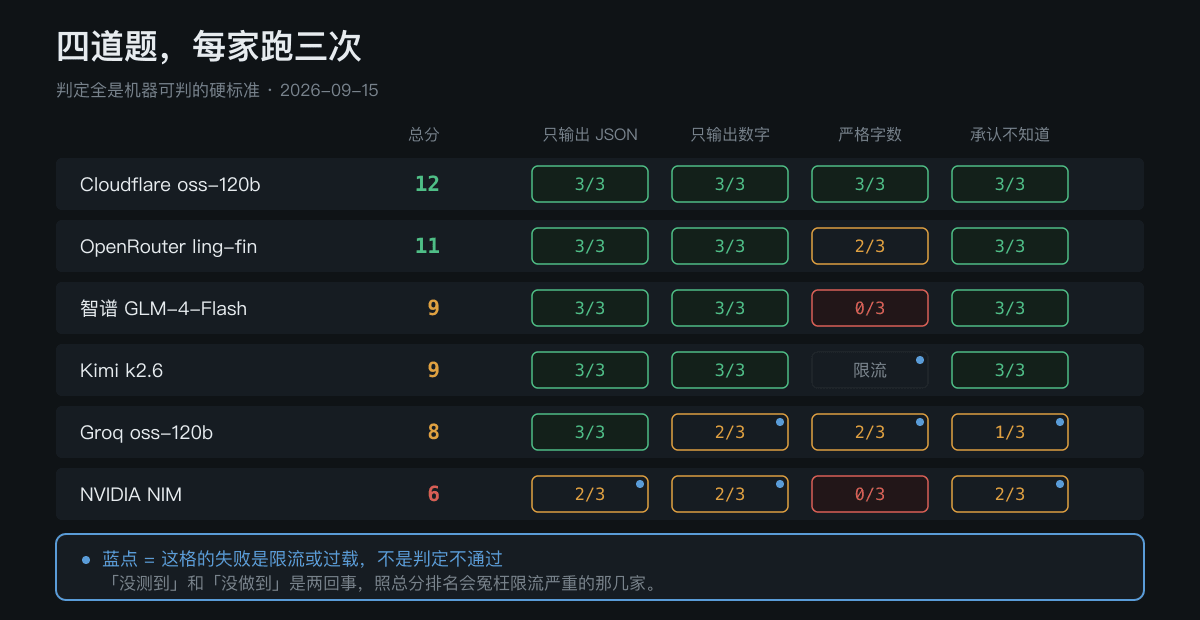
| 入口 | 总分 | JSON | 数字 | 字数 | 承认不知道 |
|---|---|---|---|---|---|
| Cloudflare oss-120b | 12/12 | 3/3 | 3/3 | 3/3 | 3/3 |
| OpenRouter ling-3.0-flash-fin | 11/12 | 3/3 | 3/3 | 2/3 | 3/3 |
| 智谱 GLM-4-Flash | 9/12 | 3/3 | 3/3 | 0/3 | 3/3 |
| Kimi k2.6 | 9/12 | 3/3 | 3/3 | 限流没测到 | 3/3 |
| Groq oss-120b | 8/12 | 3/3 | 2/3 | 2/3 | 1/3 |
| NVIDIA NIM | 6/12 | 2/3 | 2/3 | 0/3 | 2/3 |
这张表有个地方得先说清楚,不然会看错。
Groq、Kimi、NVIDIA 那几个不满分的格子里,有相当一部分失败不是判定不通过,是压根没测到:Groq 撞的是限流,退避重试六次还是被拦;Kimi 的字数那一项三次全部撞上每分钟三次的上限;NVIDIA 是服务过载。
限流和「做不到」是两回事。照着总分排名去说谁强谁弱,会把限流严重的那几家冤枉了。
卡住多数人的是同一道题
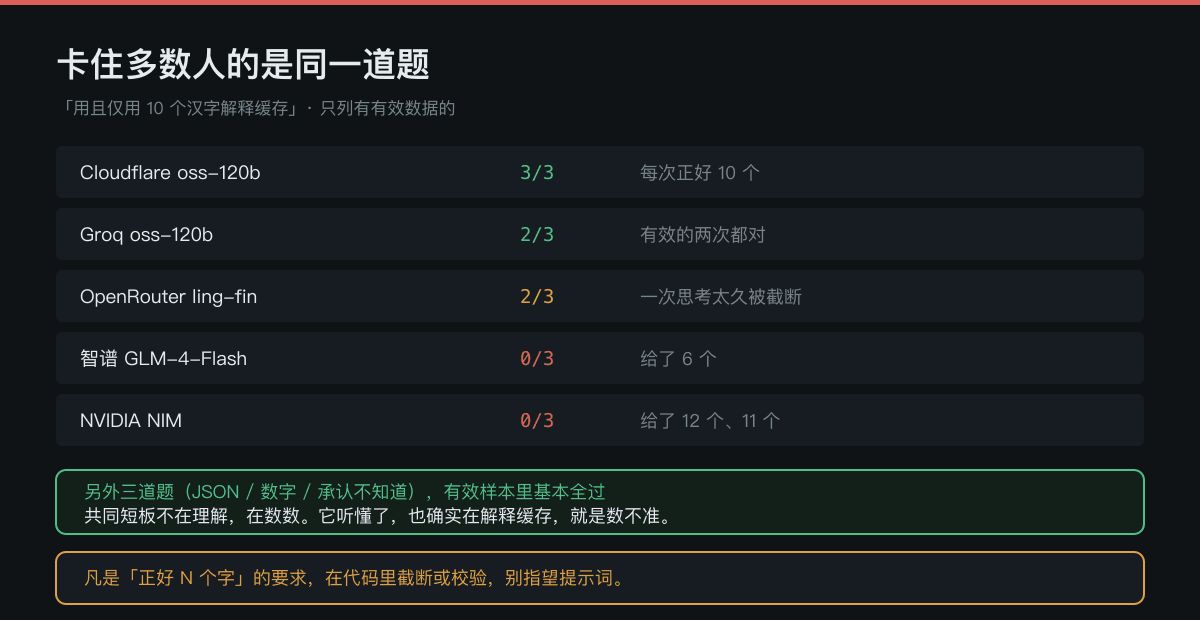
把限流的格子刨掉,只看有有效数据的:
| 入口 | 严格字数 | 实际给了几个字 |
|---|---|---|
| Cloudflare | 3/3 | 每次正好 10 个 |
| Groq | 2/3 | 有效的两次都对 |
| OpenRouter | 2/3 | 有一次思考太久被截断 |
| 智谱 GLM-4-Flash | 0/3 | 给了 6 个 |
| NVIDIA NIM | 0/3 | 给了 12 个、11 个 |
而另外三道题,有效样本里基本全过。
也就是说这批模型的共同短板不在理解,在数数。
「用且仅用 10 个汉字」这句话它完全听懂了,也确实在解释缓存,就是数不准。智谱给了 6 个,NVIDIA 给了 12 个和 11 个。
这个对实际使用的意义很直接:凡是「正好 N 个字」「不超过 N 字」这类要求,别指望靠提示词保证,该在代码里截断或者校验。
顺便说个我觉得挺有意思的:OpenRouter 那次失败,是它为了回答「用 10 个汉字解释缓存」,先思考了 3275 个字,然后把输出额度用光了,最终给出来的内容是空的。一道要求答 10 个字的题,思考了三千多字。
两个坑,不是模型的问题,是调用方式
这两个我觉得比排名有用。
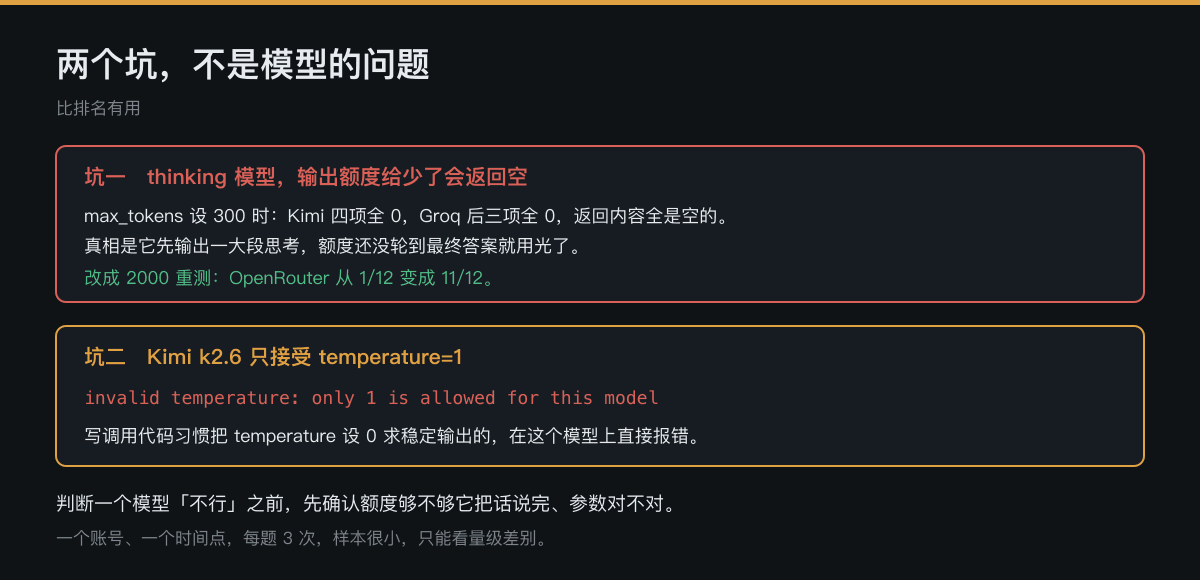
第一个:thinking 类模型,输出额度给少了会返回空。
第一轮测的时候我把 max_tokens 设成 300。结果 Kimi 四项全 0,Groq 后三项全 0,返回的内容全是空的。
看着像是这两家完全不听指令。实际上不是。这类模型会先输出一大段思考过程,300 的额度还没轮到写最终答案就用完了,content 字段自然是空的。
把额度改成 2000 之后重测,OpenRouter 从 1/12 直接变成 11/12。
所以判断一个模型「不行」之前,先确认给的额度够不够它把话说完。
第二个:Kimi k2.6 只接受 temperature=1。
传 0 会直接被拒绝:
invalid temperature: only 1 is allowed for this model
不少人写调用代码习惯把 temperature 设成 0 求个稳定输出,这个模型上直接报错,而且报错信息不看仔细的话,很容易以为是别的问题。
所以怎么用
要做自动化就用 Cloudflare。提结构化字段、按格式输出这类活,它四项满分,而且之前测稳定性的时候它也是 15 次全通。目前这批里最省心的。
JSON 提取这种活不用挑。大部分家都能干,按速度选就行。
别让它们数字数。这是共同短板,用代码兜。
看到低分先看是不是限流。Groq、Kimi、NVIDIA 这次的分数里都混着限流和过载,跟能力没关系。
调用参数先翻文档。temperature=0 不是哪儿都能用。
几句边界
一个账号、一个时间点,每题只跑三次,样本很小,只能看出量级差别,不构成统计结论。
四道题是我自己挑的,覆盖不了全部能力。长文本、多轮对话、工具调用都没测。
这些是各家的免费档位,跟它们的付费旗舰不是一回事。这里的结论只针对这几个免费入口,不能推广成「某家模型不行」。
Groq、Kimi、NVIDIA 那几格有限流和过载干扰,这部分数据我没拿去做横向比较,正文里也没拿它们下结论。