一本书赔 3000 美元,AI 公司赔的其实不是训练
今年 7 月,美国法院终审批准了一笔 15 亿美元的和解:一家 AI 公司赔给书的作者和出版社,48 万多部作品,平均每部约 3000 美元,是法定最低赔偿 750 美元的 4 倍。很多人把它读成「AI 用书训练从此要付钱了」,但判决的另一半说的正好相反:法官把这家公司做的事拆成三件,拿书训练算合理使用,买纸书扫描成电子版也算合理使用,只有从盗版库下载至少 700 万本书建永久库不算。15 亿的集体诉讼只针对盗版这一件。按「一本书」排一排,合法买书扫描最便宜,法定赔偿 750,和解 3000,正规授权 5000 美元还只管三年。授权费真正买的,是干净的来路、使用的边界和持续的供给。
今年 7 月 20 日,美国一家联邦法院终审批准了一笔 15 亿美元的和解。
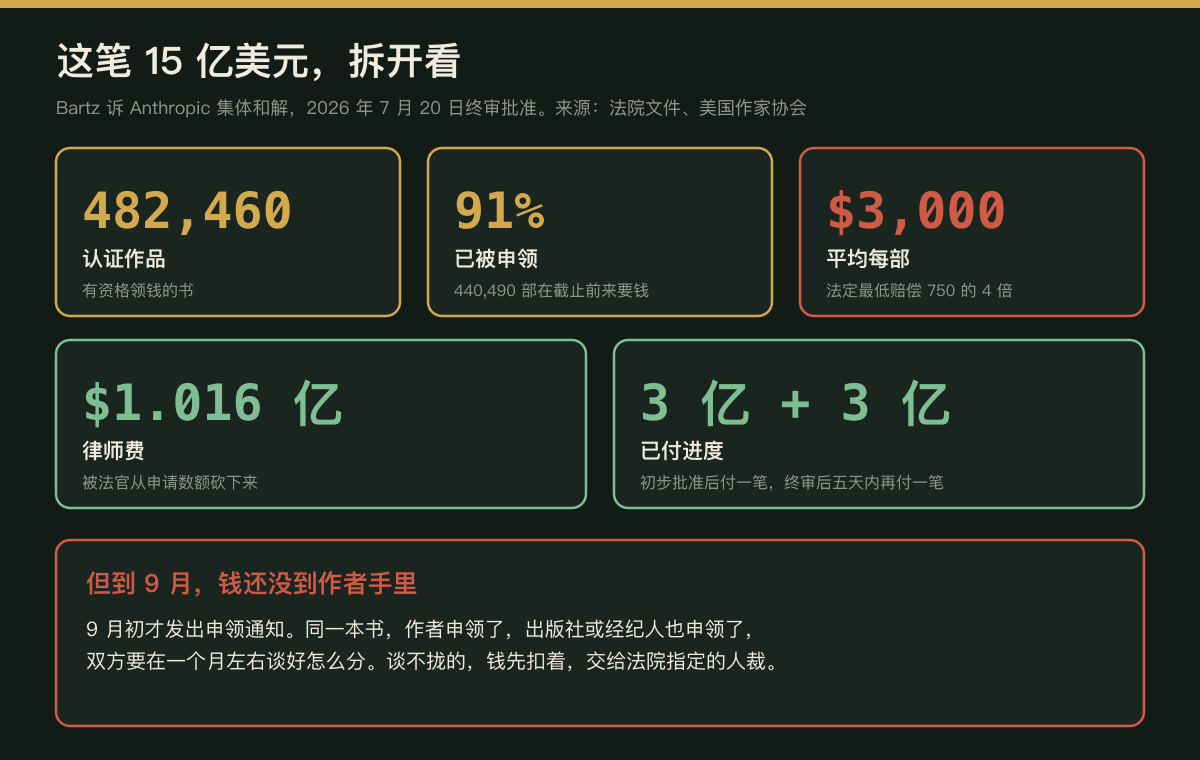
一家 AI 公司赔给了书的作者和出版社。认证作品 48 万多部,平均下来每部约 3,000 美元。法院在批准书里专门算了一句:这大约是普通侵权法定最低赔偿 750 美元的 4 倍。
很多报道把它解读成一个信号:AI 拿书去训练,从此要付钱了。
我把判决翻了一遍,发现这个读法正好反了。
这 15 亿,赔的不是训练。
一、先看这笔钱本身
和解的对象是 Anthropic,就是做 Claude 的那家公司。案子叫 Bartz 诉 Anthropic,一年前初步批准,今年 7 月由接手的法官终审批准,原来那位法官已经退休了。
几个数:
认证作品 482,460 部,截至今年 3 月 30 日有 440,490 部被申领,超过 91%。几乎所有有资格的书都来要钱了。
律师费被法官砍到了约 1.016 亿美元。公司已经先付了 3 亿,终审后五天内再付 3 亿。
但钱到现在还没到作者手里。9 月初才把申领通知发下去,一个常见的卡点是:同一本书,作者申领了,出版社或者经纪人也申领了,双方得在一个月左右谈好怎么分。谈不拢的,钱先扣着,交给法院指定的人来裁。
二、判决的另一半,很少有人提
这笔和解之前,还有一份 2025 年 6 月的判决。那份判决才是关键。
法官把这家公司对书做的事,拆成了三件,一件一件判:
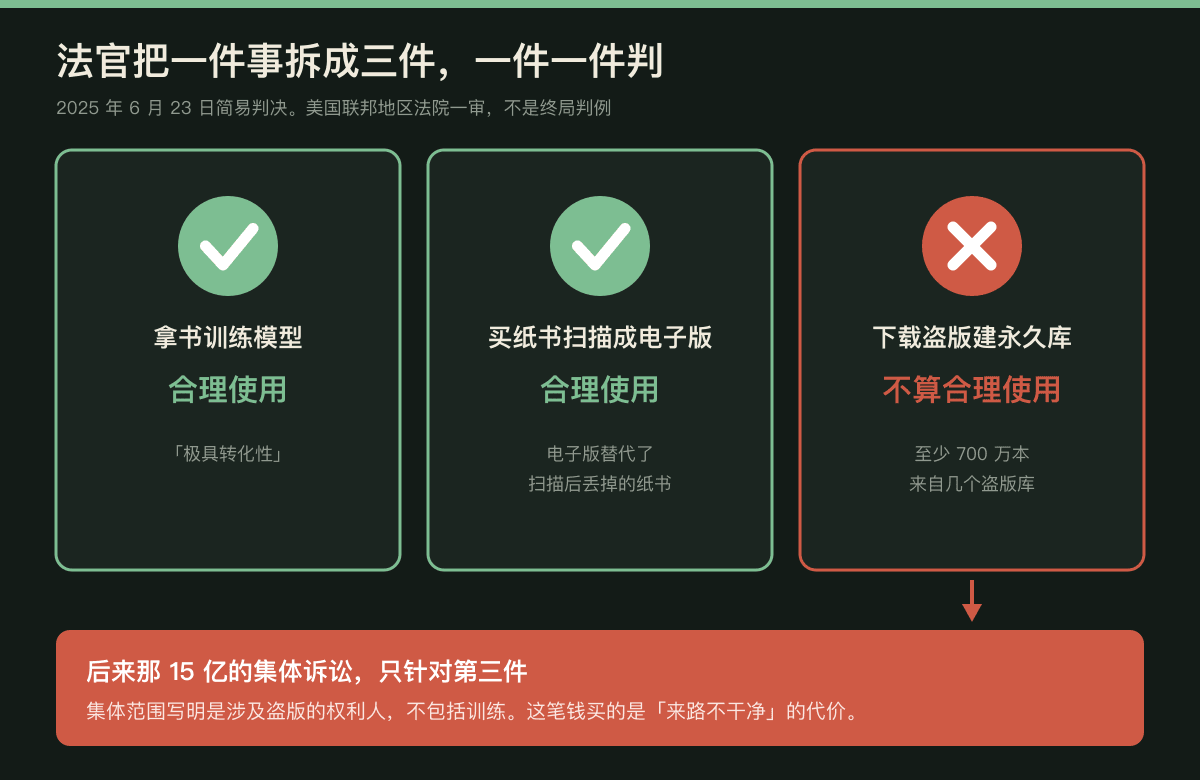
第一件,用书训练模型。判的是合理使用。法官的原话是这种使用「极具转化性」。
第二件,把买来的纸书拆掉装订、切开书页、扫描成电子版。也是合理使用,理由是电子版替代了扫描后丢掉的那本纸书,本质上是换了个存法。这家公司真这么干过,批量买了几百万本纸书。
第三件,从盗版网站下载书、存成一个永久的库。这件不算合理使用,进入审判程序。法官认定它从几个盗版库里下载了至少 700 万本。
后来那个 15 亿的集体诉讼,只针对第三件。集体的范围写得很清楚:涉及盗版的那部分权利人,不包括训练。
所以这笔钱的真实含义是:来路不干净的代价。
至于训练本身,按这份判决,合法买来的书拿去训练,在美国目前不需要单独付钱。
要补两句公道话。这是地区法院的一审判决,不是最高法院的终局判例;而且训练合理使用这个认定,严格说只对那三位署名原告有效。两天后另一位法官在 Meta 的案子里也认定训练「高度转化」,但两位法官都说了,换一套经济证据,结论可能不一样。纽约时报诉 OpenAI 这类案子也还在打。
三、那「正常买」要花多少钱
既然偷来的书要赔,那么老老实实买授权,是什么价?
公开的交易里,最能对上「一本书」这个单位的,是 HarperCollins 和微软那笔:
每本书 5,000 美元,作者和出版社各拿 2,500。作者得主动同意才算。条件也写得很细:只限非虚构类,授权只有三年,到期就得停用;模型输出不能连续超过 200 个词,或者超过全书的 5%。
把几个价格按「一本书」排一排,会出现一个挺反直觉的阶梯:
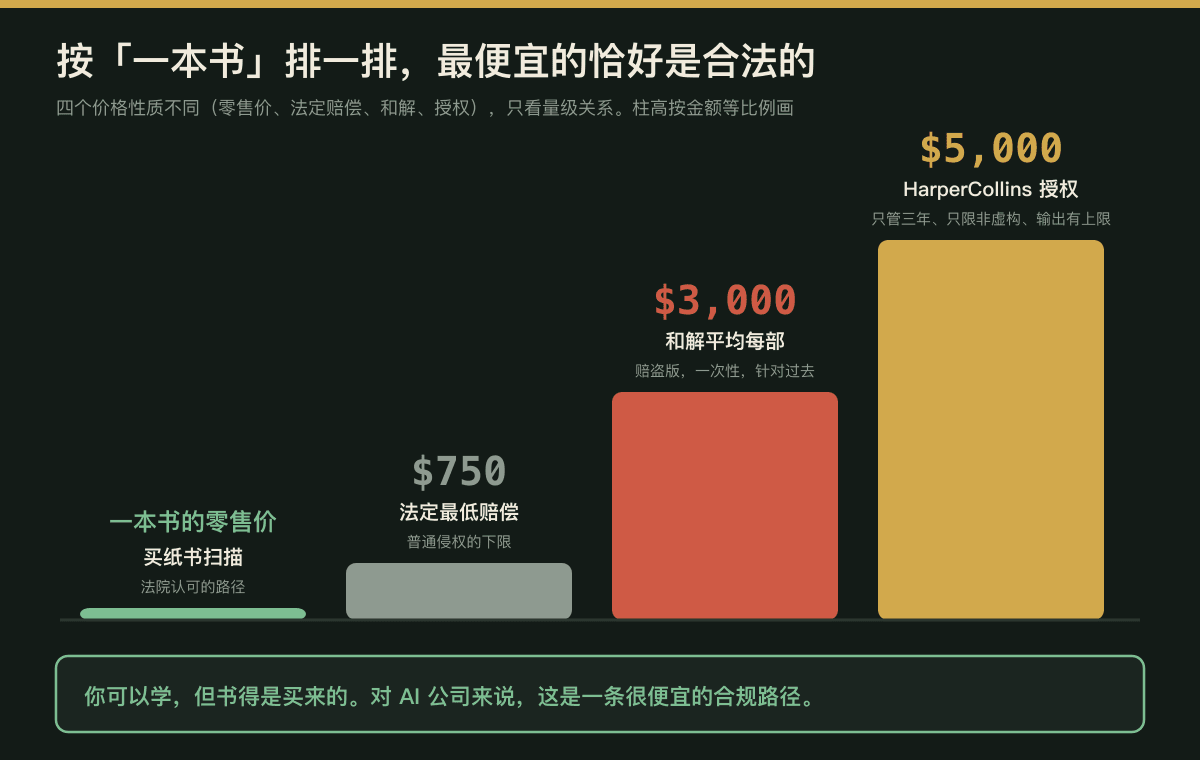
合法买一本纸书来扫描,花的是一本书的零售价。 普通侵权的法定最低赔偿,750 美元。 这笔和解平均到每部,约 3,000 美元。 正规授权,5,000 美元,还只管三年。
最便宜的那条路,恰好是法院认可的那条路。
四、那授权交易里,钱到底买的是什么
这是我觉得最值得想清楚的一点。
如果合法买书训练已经被认定为合理使用,微软为什么还要花 5,000 美元一本去签授权?
我的理解是,授权费买的从来不是「被学过一次」这件事,买的是三样别的东西。
一是干净的来路。有一份签了字的授权,以后不用担心被追着打官司。上面那 15 亿,就是来路不干净的价格。
二是使用的边界。三年期、限非虚构、输出限 200 词,这些条款双方都有好处:出版社知道书不会被原样吐出来,买方知道自己能用到哪一步。
三是持续的供给。这一条在平台型的交易里最明显。
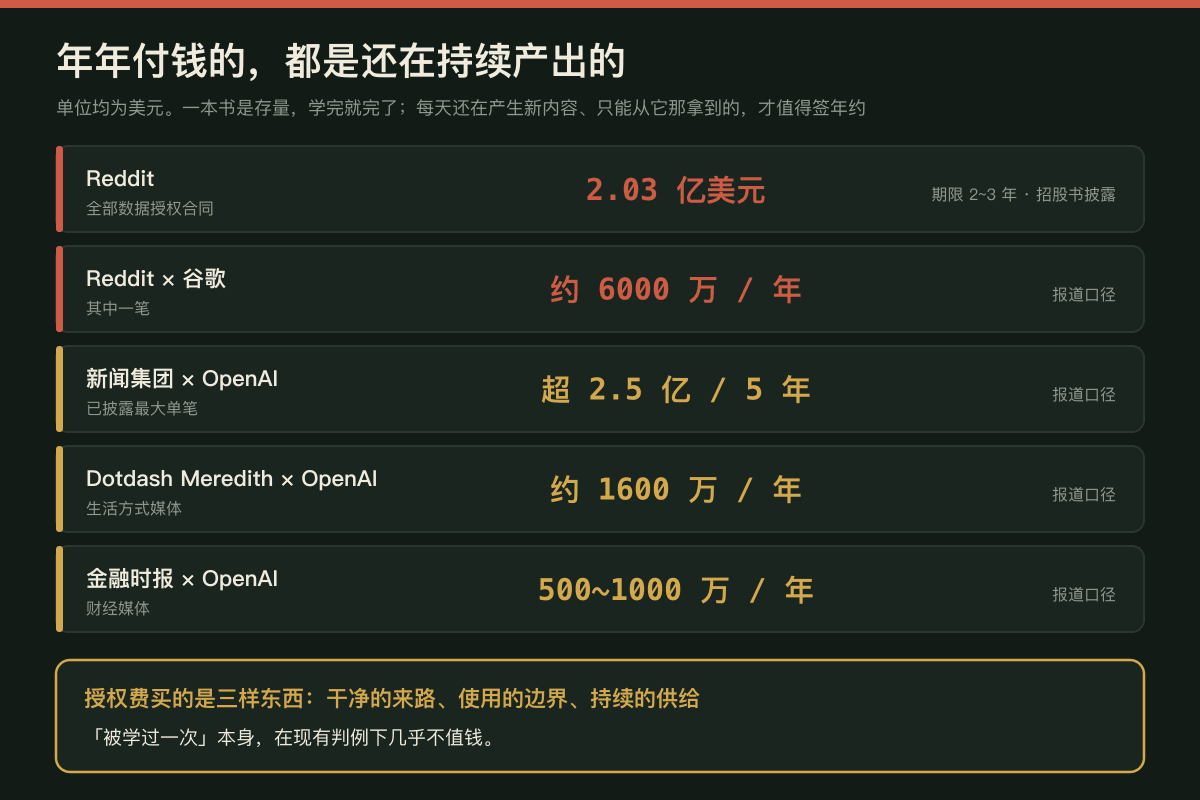
Reddit 在招股书里披露,它的数据授权合同总额 2.03 亿美元,期限两到三年。按报道,其中和谷歌那笔大约每年 6,000 万美元。新闻集团和 OpenAI 签的是五年超过 2.5 亿美元,是目前披露过的最大单笔。
一本书是存量,买一次,学完就完了。但 Reddit 每天还在产生新的真人对话,新闻集团每天还在出新的报道。AI 公司愿意年年付钱的,是这种只能从它那里持续拿到的东西。
反方的声音也要放上来。有新闻机构的负责人说过,如果被搜索引擎收录就等于喂了训练,那数据的实际价值就是零,唯一的选择只剩彻底从搜索结果里消失。这话说得很重,但它戳中的正是上面那个逻辑:存量的、公开的、谁都能拿到的内容,议价能力很弱。
五、对写东西的人意味着什么
这些都是美国的案子和交易,国内的规则还在形成,我不做判断。但定价的逻辑是相通的。
第一,作品「被学过」本身,在现有判例下不太值钱。值钱的是来路、边界和持续供给。如果你的东西只是公开放着的一次性内容,它的谈判筹码是最弱的那种。
第二,平台签的授权,钱首先到平台。Reddit 那 2 亿多,是 Reddit 的收入。发帖的人是内容的来源,但不是合同的一方。
第三,持续产出的、别处拿不到的内容,才有定价权。一个每天在更新、只有你这里有的东西,和一本已经出版的书,在 AI 公司眼里是两种资产。
最后
15 亿美元这个数字太大,大到很容易被读成「AI 从此要为学习付钱了」。
但把判决翻开,它讲的是另一件更朴素的事:你可以学,但书得是买来的。
对 AI 公司来说,这其实划了一条很便宜的合规路径。对写东西的人来说,真正要想的问题也就变了:别人从我这里拿走的,是一次就够的东西,还是得一直回来找我的东西。
几句边界
和解金额、每部金额、认证与申领数量、律师费、付款进度,来自法院文件及美国作家协会等公开信息。截至 9 月,作者与出版社共同申领的款项仍在协商分配。
三件事分开判的内容,来自 2025 年 6 月 23 日的简易判决。这是美国联邦地区法院的一审判决,不是终局判例,训练属合理使用的认定仅对三位署名原告直接有效,同类案件仍在进行。
HarperCollins 的授权条款来自出版方与作家协会的公开说明;Reddit 的 2.03 亿美元来自其招股书,与谷歌每年约 6,000 万美元、新闻集团与 OpenAI 五年超过 2.5 亿美元等为报道口径。
价格阶梯是我按「一本书」为单位做的对比,四个价格性质不同(零售价、法定赔偿、和解、授权),只用于说明量级关系。本文不构成法律意见。