输出免费的 AI 模型来了,但最关键的那个数没公开
TypeSafe AI 在 9 月 16 日发布了 Jev,一个一个字都不写的模型:你把材料和选项一起给它,它只还你三种东西,选一个、给个是非概率、或者打个分,每个都附带一个「把握」值。它的输出免费,因为它压根没有「写」这个动作可以收费,而输入仍然按每百万 token 0.042 美元计价。架构官方没公开,但从计费逆向能推出它砍掉的只是大模型最后那个逐字循环,骨架很可能没换。问题在于:它的全部用法建立在「把握高就自动放行、把握低才请大模型」这道闸门上,而这个把握值准不准,官方没有给出任何可验证的数字,评测方法还是拿另外两个模型预测的平均当参照,原理上就算不出校准。
先看一个真实的请求,看完你就知道这东西是干嘛的了。
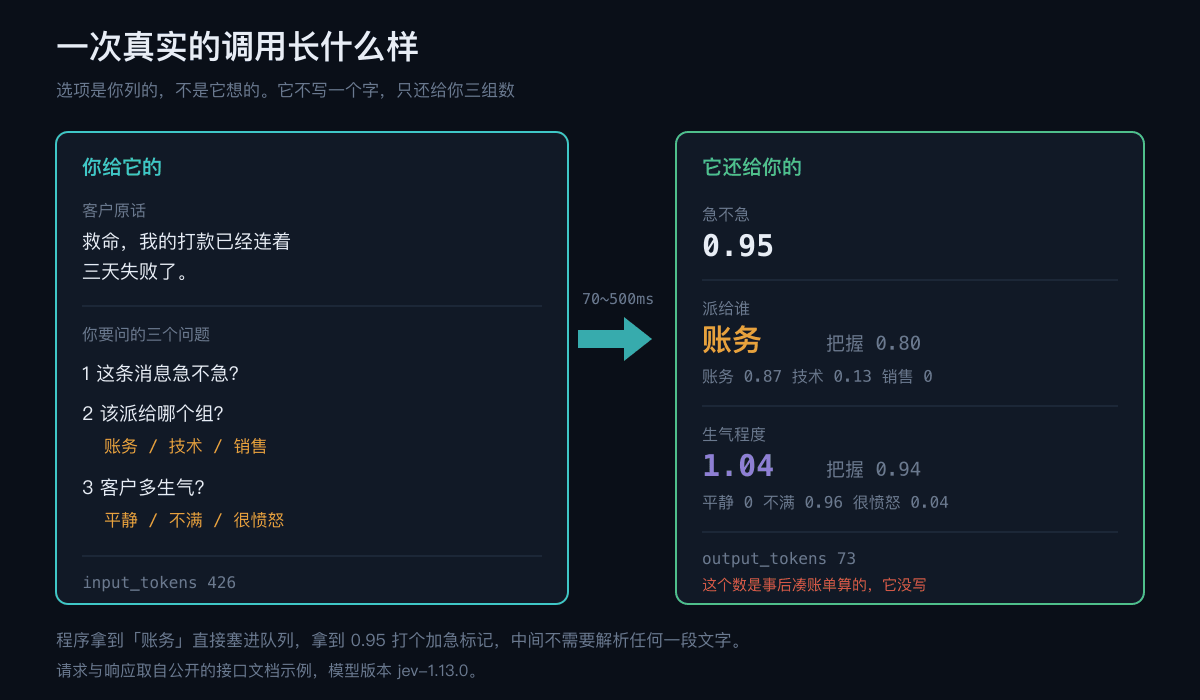
你丢给它一句客户原话:
救命,我的打款已经连着三天失败了。
再附上三个问题,选项由你自己列好:
- 这条消息急不急?
- 该派给哪个组?账务 / 技术 / 销售
- 客户多生气?平静 / 不满 / 很愤怒
它返回给你的是这个:
第一个问题,急不急:0.95。
第二个问题,派给谁:账务,把握 0.80。三个选项各自的概率是账务 0.87、技术 0.13、销售 0。
第三个问题,多生气:1.04 分,把握 0.94。三档的概率是平静 0、不满 0.96、很愤怒 0.04。
没有一句话,只有三组数。
你的程序拿到「账务」就把工单直接塞进账务组的队列,拿到 0.95 就打个加急标记。中间不需要解析任何一段文字。
这个模型叫 Jev,9 月 16 日发布,来自隐身了两年的 TypeSafe AI。创始人 Diogo Almeida 是 ChatGPT 的共同发明人之一,公司拿了 4000 万美元种子轮。
它最反直觉的地方是:它一个字都不写。
一、它只会做三种题
看懂上面那个例子,就等于看懂了它的全部本事。它只认三种题型:
选择题。从你给的几个选项里挑一个,最多 255 个。返回你挑中的那个,外加每个选项各自的概率。
是非题。返回一个 0 到 1 的数,0.95 就是「95% 的可能是」。
打分题。你给几个档位,它给一个分,可以带小数。1.04 就是「介于不满和很愤怒之间,明显偏不满」。
这三种之外,它一件事都干不了。不会写摘要,不会回复客户,不会写代码。
官方文档里还有两个例子,能看出它想接的活是什么。
退款审核。把工单、订单记录、退款政策一起丢进去,问两个是非题:客户是在要求退款吗,按这份政策这笔该不该退。订单里明明白白有两笔 49 美元都已扣款,政策写着重复扣款可退,它给了 0.99 和 0.98。
账号风控。开户 12 天、五次登录失败、在新国家请求改密码、但常用设备也成功登录过。它给出风险 1.84 分(0 低 / 1 中 / 2 高),三档概率是低 0、中 0.16、高 0.84,并在「要不要转人工」上给了 0.81。
说句我自己的看法:风控这个我觉得它偏保守了。常用设备成功登录过是很强的「没被盗」信号,它还是压到了 0.84。当然风控上多疑一点不算毛病。
而客服那个我反倒觉得挺讲究:打款失败它给账务 0.87,同时给技术留了 0.13。打款失败确实也可能是支付通道挂了,它没把话说死。
二、为什么它快,为什么输出免费
要讲清楚这个,得先看普通大模型是怎么写字的。
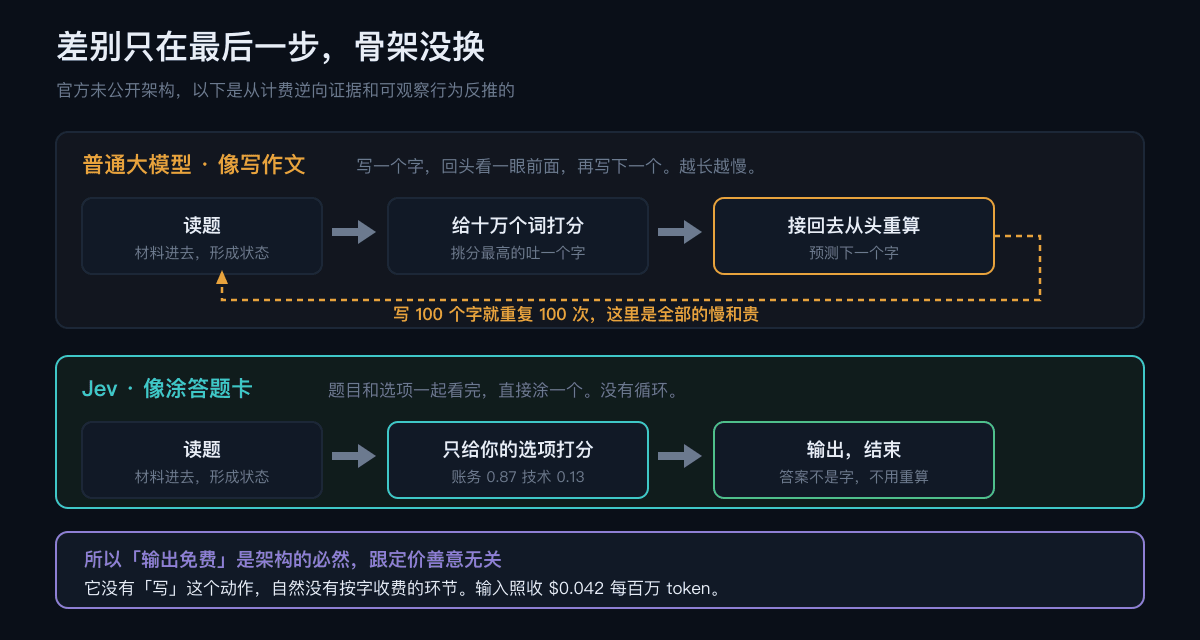
ChatGPT 写一句话,实际流程是:
- 把你的问题整个读进去,模型内部形成一个状态
- 根据这个状态,给词表里所有的词打分,挑分最高的吐出来
- 把刚吐出来的字接到问题后面,从头再算一遍,预测下一个字
- 重复第 3 步,直到写完
第 3 步是所有慢和贵的根源。写 100 个字就要重复 100 次。你要是用那种会「思考」的模型,它还会先在心里写一大段推理,那就是几百上千次重复,而且每个字都要收钱。
Jev 的流程是:
- 把材料和选项一起读进去,形成状态。这一步跟大模型一模一样。
- 不给十万个词打分,只给你列的那三个选项打分:账务 0.87、技术 0.13、销售 0
- 输出。结束。
没有循环。答案是从几个选项里挑出来的一个,本身就不是字,不需要接回去重算。
打个比方。
大模型像写作文。写一个字,回头看一眼前面写了什么,再写下一个。写得越长越慢。
Jev 像涂答题卡。题目和选项一起看完,直接涂一个。
关键在于:涂答题卡的快慢只取决于题目读完没有,跟选项有几个关系不大。
所以「输出免费」这件事的性质,跟大家想的不太一样。这是架构上的必然,跟定价善意没什么关系:它没有「写」这个动作,自然就没有按字收费的环节。官方在价目表上写的是「too cheap to meter」,便宜到不值得计量。
顺带把话说全:输入还是要钱的,$0.042 每百万 token,而且现在是排队申请的早期访问,普通人今天用不上。
三、那它到底是不是新架构
这里得先说清楚:TypeSafe 没公开架构。官方的说法是暂时不讲,论文以后可能有。开发者社区里从文本扩散一路猜到编码器加分类头,没有定论。
所以下面是从证据反推的,不是官方说法。
有人把它的计费数据扒了一遍,找到两个对不上的地方。
第一,一个 255 选项的请求,账单上写着「输出了 2714 个 token」,但它返回的速度跟只有两个选项的请求一样快。真写 2714 个 token 不可能这么快。
第二个更有意思。这个「输出 token 数」会跟着问题标识符的长短变化,而官方文档白纸黑字写着,这个标识符不会发给模型、不参与推理。
模型压根没见过的东西,怎么可能影响它「写了多少」?只有一种解释:那个数字是推理结束之后,按公式从返回结果上算出来凑账单的。它根本没写。
由此能排掉两种可能:不是逐字生成,也不是扩散模型(扩散需要反复迭代,255 个选项不可能和 2 个选项一样快)。剩下的是一次读完、直接从一个分类头上读数。
那它是不是 transformer?几乎肯定是,而且骨架很可能跟大模型是同一套。
两条理由。一是计费呈现出「共享前缀」的特征:同一批材料问好几个问题,材料只收一次钱,这是把读过的东西缓存下来别重读的典型做法,而这是 transformer 的标配。二是它得有相当扎实的世界常识,才能判断「打款失败」该归账务还是技术,而这种见识只能靠海量文本预训练来。
所以准确的说法是:骨架没换,换掉的是最后一层,外加训练方法。
这里还有个容易被绕晕的点,我觉得值得专门说一句:
大模型的最后一步,本来就是在做选择题。它预测下一个字,本质上是在词表的十万个词里做一道「十万选一」。
Jev 做的事情,是把这道题从「十万选一」改成「你给的三选一」,然后只做一次,不循环。
做逆向那位说了句很到位的话:语言模型的输出层本来也就是一个矩阵加一次归一化,你换成专门的分类头,从外面根本看不出区别。
这是一个漂亮的工程选择,但官方把它叫做「一类新的前沿模型」,我觉得说大了。
四、「输出免费」到底省多少,我算了一下
这是我自己算的,假设写在这儿:一次决策任务输入 2000 token。
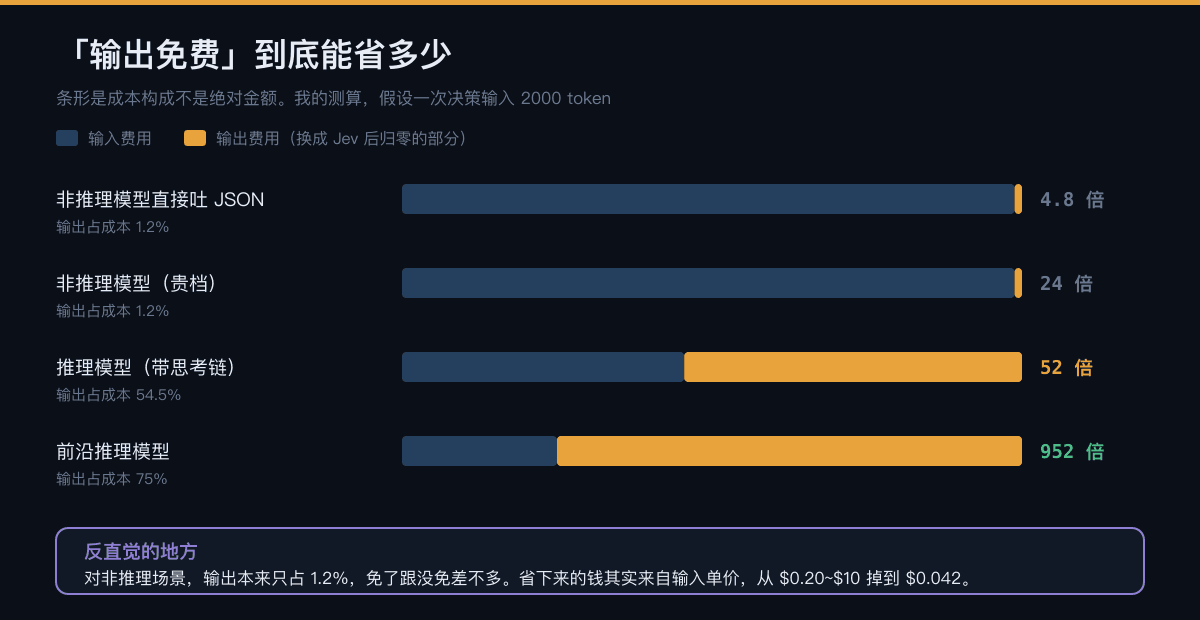
| 你原来用什么做决策 | 输出占总成本 | 换成 Jev 省 |
|---|---|---|
| 非推理模型直接吐 JSON | 1.2% | 4.8 倍 |
| 非推理模型(贵档) | 1.2% | 24 倍 |
| 推理模型(带思考链) | 54.5% | 52 倍 |
| 前沿推理模型 | 75.0% | 952 倍 |
结论有点反直觉:
「输出免费」这个卖点,对非推理场景几乎是个空头人情。因为输出本来就只占成本的 1.2%,免了跟没免差不多。真正把钱省下来的是输入单价,从常规的每百万 0.2 到 10 美元,掉到 0.042 美元。
只有当你原来在用推理模型硬做分类,也就是让一个会思考的模型先写一大段推理再给答案,这时候输出占到一半以上,「输出免费」才真的值钱。
顺手核了一下他们的账。官方那个让 Jev 玩《毁灭战士》的演示,每秒 10 次调用、约 7 美元一小时,折下来每次 0.0001944 美元,按 0.042 的单价反推,每次输入大约 4630 token。游戏状态的体量对得上,定价是自洽的,没有虚标。
五、他们真正做的硬活只有一件
抛开包装,实打实的东西有三样:并行采样(一次问五个问题同时算)、255 以上的两段式处理(先单独打分再挑),还有第三样。
第三样是唯一的硬活:把「把握」这个数训准。
这件事难在哪?GPT-4 的技术报告里有张图说得很直白:预训练完的模型,说八成把握就真有八成准;但经过后训练之后,这个能力明显变差了。报告的原话是,后训练严重损害了校准。
翻译成人话:我们把模型调得会聊天、会听话的同时,顺手把它「知道自己几斤几两」这个能力搞坏了。它变得爱逞强。
TypeSafe 的训练方法就是专门冲这个真空去的:不训练它把话说漂亮,只训练它把把握说准。
这个方向我认为是对的,而且是个真问题。但麻烦也正好在这儿。
六、最要紧的那个数,一个都没给
先说清楚这个数为什么要紧。
Jev 的真实用法是这样的:它说有把握的,机器直接照做;它说没把握的,再花钱请大模型来看一眼。
省钱全靠这道闸门。
那问题就来了:它说的「把握 0.8」,到底准不准?
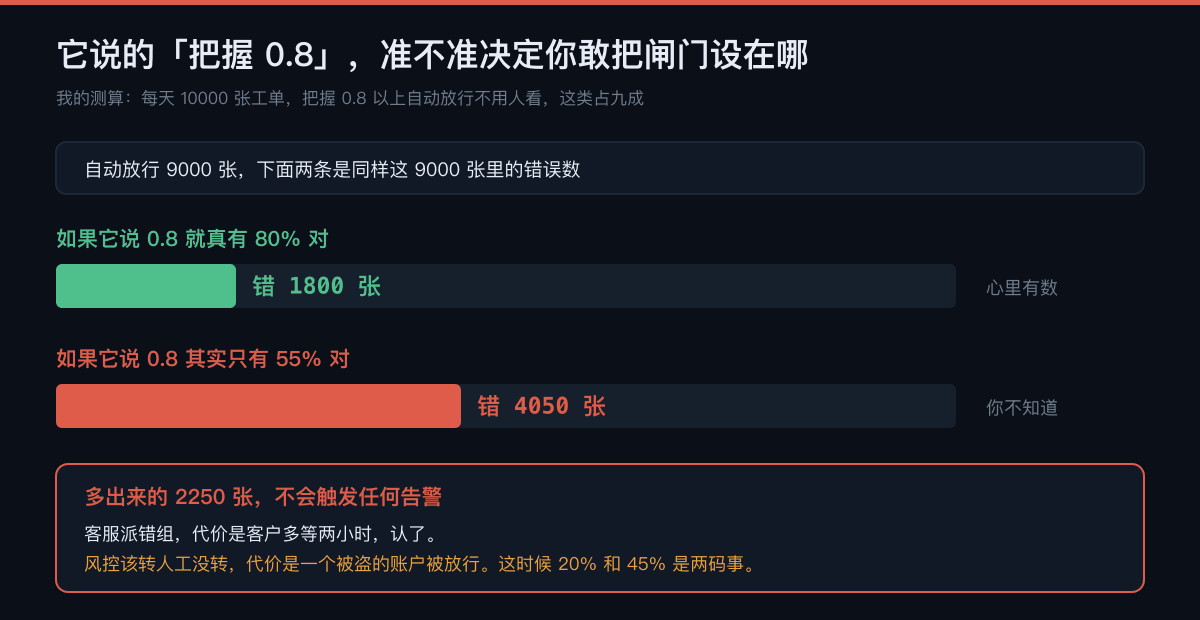
算笔账。假设你每天 10000 张工单,定个规矩:把握 0.8 以上的自动派单不用人看,这类占九成,也就是 9000 张。
如果它说 0.8 就真有 80% 对,9000 张里错 1800 张。你心里有数,可以据此安排兜底。
如果它说 0.8 其实只有 55% 对,错 4050 张。多出来的 2250 张,你完全不知道它们存在。
在客服场景,派错组的代价是客户多等两小时,认了。但换成前面那个风控的例子,「该转人工的没转」等于一个被盗的账户被放行了,这时候 20% 和 45% 就是两码事。
所以这个数准不准,直接决定你敢把闸门设在哪。
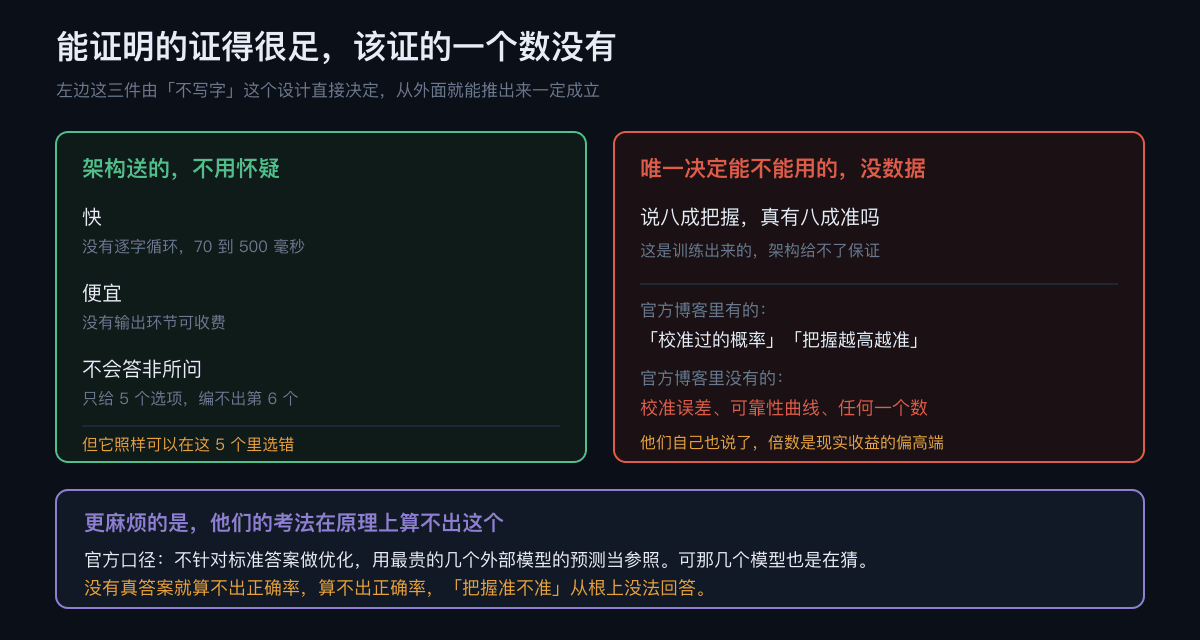
而官方博客里,没有校准误差,没有可靠性曲线,没有任何一个可以验证的数字,只有形容词:「校准过的概率」「把握越高越准」。
七、更麻烦的是,他们的考法算不出这个
这才是我最在意的一点。
他们的评测方法,官方是这么写的:不针对标准答案做优化,改成假设存在一个正确的计算流程,用最大、最聪明、最贵的那几个外部模型的预测当作参照概率。具体来说,是取 Astra 和 Fable 两个模型的平均。
问题在于,那两个模型也是在猜。
拿别人的猜测当标准答案,量出来的是「你跟他们猜得像不像」,不是「你对不对」。
而「把握准不准」这件事,定义上就必须有确凿的对错才能算:你说八成把握,得知道你实际对了几次,才知道这八成是不是吹的。
没有真答案,就算不出正确率;算不出正确率,「把握准不准」这个问题从根上就没法回答。
这是方法本身的问题,不是态度问题。他们其实相当坦诚,主动写了不少保留:四个测试流程是自家团队做的人写的、可能存在偏差、那些倍数是现实收益的偏高端、评测是在西海岸的笔记本上跑的、也没法自证定价没被补贴。开发者社区里还有人指出,官方自己贴的某张图里,Jev 的原始准确率是低于 Sonnet 5 的。
顺带说一句「不会幻觉」。这个说法只成立一半:你只给它 5 个选项,它当然编不出第 6 个,但它照样可以在这 5 个里选错。编不出来和不会错,是两回事。
八、还有一个实实在在的坑
官方文档里有句容易被略过的话:同一次请求里的几个问题,互相看不见对方的答案。
退款那个例子里,「是不是在要求退款」和「政策支不支持」两个判断彼此独立,一起问没问题。
但你要是接着想问「那该退多少钱」,这个判断依赖前面的结论,就得重新发一次请求,并且把订单、政策、工单这些材料再传一遍。而输入是收费的。
意思很明确:它快,前提是你的判断彼此独立。一旦你的流程是「先判断类型,再根据类型决定下一步问什么」,就得一轮一轮来,说好的快 200 倍要打折。
这算不上缺陷,它是并行的必然代价。但选型的时候得先看看自己的流程长什么样。
九、拿到之后怎么自己验
等真拿到访问权限,别急着接生产。这套动作花不了半天:
第一步,攒 300 到 500 条你自己业务上已经有正确答案的历史数据。工单派错过没有、退款最后退没退、账号最后是不是真被盗了,这些你本来就有记录。
第二步,全量跑一遍,把它给的把握值和真实对错一起存下来。
第三步,按把握值分箱。0.5 到 0.6 一箱、0.6 到 0.7 一箱,以此类推。每一箱里算一下实际正确率。
第四步,把「它说的把握」和「实际正确率」画成一张图。如果两者基本落在一条斜线上,说明它的把握是可信的,你可以放心按阈值设闸门。如果它说 0.8 的那一箱实际只有 0.55,那这个模型在你的场景上就是逞强的,闸门得往上抬,或者干脆别用这套自动放行的玩法。
第五步,用这张图反推你的阈值。你能容忍多少错误率,就去图上找对应的把握值,而不是拍脑袋定 0.8。
这件事的成本很低,几百条数据、几美元的调用费。但它是唯一能替代官方那个缺失数据的办法。
十、我的判断
把这些串起来,结论其实挺清楚。
架构送给它的三件事,不用怀疑:快、便宜、不会答非所问。这三样是由「不写字」这个设计直接决定的,我从外面就能推出来一定成立,不需要谁来背书。
而它宣传的核心卖点,跟架构无关。「说八成把握就真有八成准」这件事是训练出来的,架构给不了任何保证,官方也没给任何数据,评测方法在原理上还算不出它。
能证明的证得很足,该证的一个数没有。
但我不想把这篇写成唱衰,因为它赌的那个判断我是认同的:
软件里绝大多数的 AI 调用,根本不需要它说话。这个工单派给谁、这段内容拦不拦、这个字段映射到哪,要的都只是一个判断。而我们现在的标准做法,是让一个被训练来写字的模型先写出一段字,再用正则把字从里面抠出来当决策。
这条链路本身就是歪的。我们一直在为「它得先说话」付钱。
现在有人拿 4000 万美元赌这一段该被拆掉。这个赌注我觉得是对的。公司名字取自杰文斯,那位发现「东西变便宜、总用量反而暴涨」的经济学家,意思也很明白:他们不打算靠单价赚钱,赌的是机器判断便宜到不计价之后,开发者会把 AI 塞进软件的每一个角落。
最后说个巧合。
我前两天刚写过一组研究,说的是拿大模型去验收 AI 干的活有多不靠谱:它在读语气,而语气恰恰是最容易伪装的东西,更麻烦的是它从来不告诉你它什么时候在猜。
Jev 正好长在这个伤口上:它不生成语气,只给判断,而且每个判断都附上一个把握值。
方向是对的。只不过现在的位置是:我们从「它不告诉你它在猜」,走到了「它告诉你它有多确定,但你没办法验证这个数准不准」。
这算往前走了一步。但只有一步。
几句边界
Jev 的定价、速度倍数、题型定义、255 上限、评测方法和公司的自我保留,均出自官方博客与公开的接口文档,引用处已标明是官方口径。
架构部分官方没有公开,文中的推断基于独立技术分析给出的计费逆向证据,以及可公开观察到的行为。该分析作者自己也说明了整体重构带有推测成分,无法证明存在独立的分类模块。我按同样的标准处理:能从证据排除的我写了,不能确定的我标了。
成本对比那张表和阈值那笔账是我自己算的,假设写在正文里,可以自行验算。不同任务的 token 长度差别很大,数字会变,结论的方向不变。
关于后训练损害校准,出自 GPT-4 技术报告,在 MMLU 子集上测量。
Jev 目前是排队申请的早期访问,我没有拿到实际调用权限,文中没有任何一条数据来自我自己的实测。所有具体数字都注明了来源,第九节那套验证方法是我给出的操作建议,尚未在真实数据上跑过。