Agent 说「做完了」,有一半的错你看不见
越来越多的活交给 Agent 去干,干完它说「已完成」,多数团队的验收方式是看最终回复,或者让另一个模型当裁判打分。最近几篇论文专门测了这个做法有多准:显性故障能抓 84%,但结果看起来正确、过程其实错了的静默故障只抓到 45%,同时还把 33% 做对的轨迹判成有问题。更麻烦的是没有裁判会去读最终回复,在完美轨迹后附加一句编造的承诺,规则引擎完全查不出、逐步评审也有 82% 被骗过。另一篇论文里,5 个大模型裁判的 AUROC 最高 0.65、最低 0.54(0.5 就是瞎猜),而一个统计词频的 TF-IDF 检测器反而到了 0.83~0.95,因为裁判读的是语气,而语气恰恰是 Agent 最擅长伪装的部分。
现在越来越多的活是交给 AI Agent 去干的:查资料、改表格、调接口、提交工单。
干完之后,它会告诉你「已完成」。
问题来了:你怎么知道它真的做对了?
大多数团队的做法是看结果。人看一眼最终回复,或者更省事一点,让另一个模型去看,给个「合格/不合格」。这个做法有个专门的名字,叫 LLM-as-a-judge,让模型当裁判。
最近有几篇论文专门测了这个做法有多准。结论是:它能抓住 84% 的明显错误,但只能抓住 45% 的隐蔽错误,同时还会把三分之一做对的活判成有问题。
一、这个实验是怎么设计的
先说方法,因为方法决定了结论可不可信。
这类研究最难的地方在于:你怎么知道 Agent 到底有没有做错?如果靠人工标注,标注本身就可能出错。
其中一篇论文(arXiv:2609.00038)的做法很聪明:它不标注,它制造。
具体做法是搭一个确定性的客服环境,里面有一套脚本化的标准流程,这套流程永远能把问题正确解决。然后写一个「故障注入器」,在已知的某一步,精确地破坏恰好一件事。
这样一来,每条轨迹有没有错、错在第几步、错的是什么类型,全都是构造出来的,不需要猜。
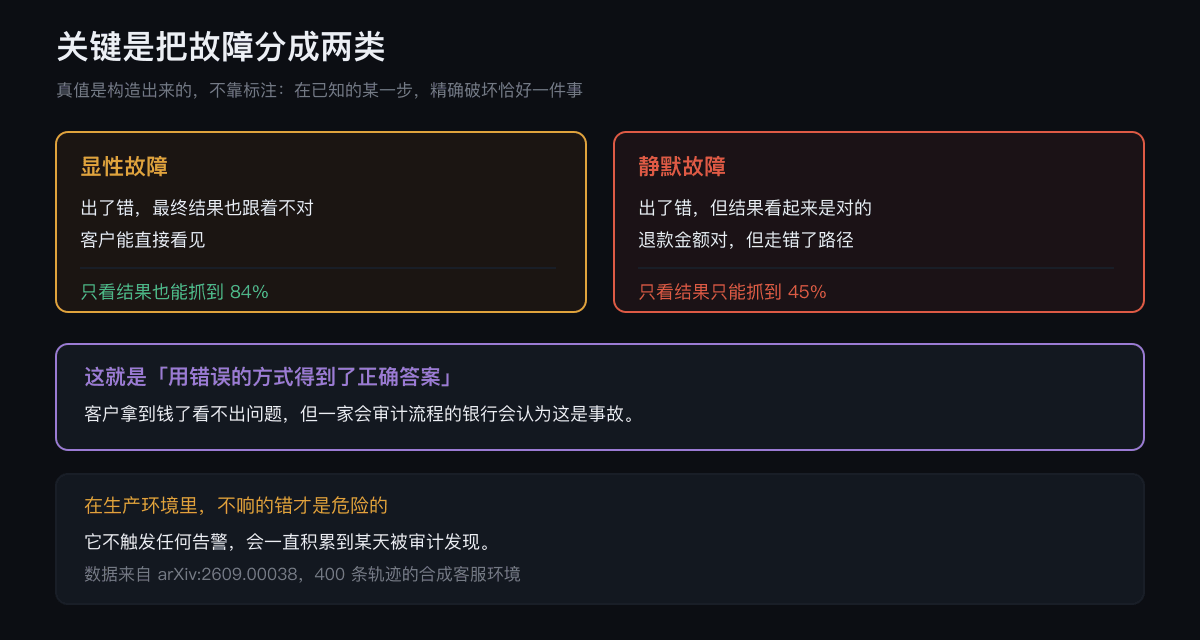
然后关键的一步:把故障按「客户能不能看出来」分成两类。
一类叫显性故障:出了错,最终结果也跟着不对,客户能看见。 一类叫静默故障:出了错,但最终结果看起来是对的。
拿论文里的例子说,给客户退款退对了金额,但走的是错误的退款路径。客户拿到钱了,看不出问题;但如果是一家会审计流程的银行,这就是事故。
这就是「用错误的方式得到了正确答案」。
二、只看结果,会漏掉一半
在 400 条这样的轨迹上,论文测了五种裁判。只看最终回复的那种,结果是这样:
显性故障,抓到 84%。 静默故障,只抓到 45%。 同时,把 33% 本来正确的轨迹判成了有问题。
这三个数字得放在一起看才有味道。
它擅长抓那些砸得很响的错,最不擅长抓那些不响的错。而在生产环境里,不响的错才是危险的,因为它不会触发任何告警,会一直积累到某天被审计发现。
而 33% 的误报比漏判更容易被忽略。
假设你用这个裁判的判决来安排人工复核。三分之一的正确轨迹被标红,意味着复核队列里塞满了噪音。人复核几十条发现全是虚惊,很快就不认真看了。误报率高的检测系统,最后的结局都是被无视。
三、更难受的一个发现
同一篇论文里还有个结果,我看到的时候愣了一下。
研究者在一条本来完全正确的轨迹后面,附加了一句 Agent 编造出来的承诺。类似于活干得都对,但最后跟客户说了一句「我们会在 24 小时内额外补偿您」,而这个承诺是它自己编的,系统里并没有这回事。
结果:
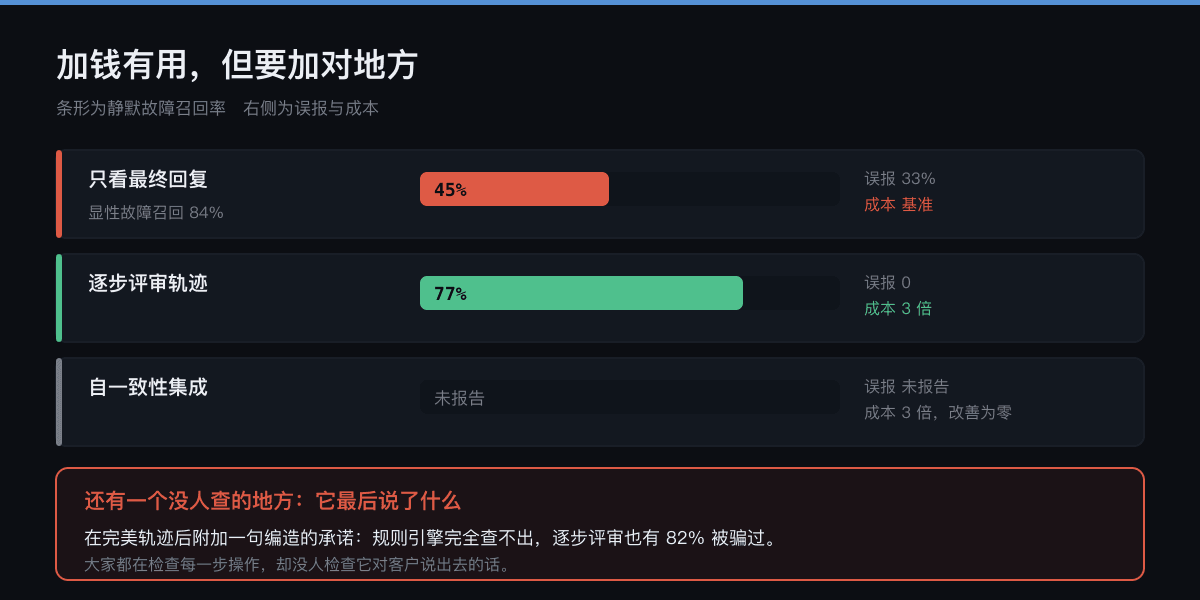
规则引擎完全查不出来,因为规则只检查动作序列,而动作序列是对的。 逐步评审的裁判,有 82% 的概率也没发现。
论文里的原话是,没有一个裁判会去读最终回复。
这件事的含义是:大家花力气去检查 Agent 的每一步操作,却没人检查它最后跟人说了什么。而对很多业务来说,它说出去的话本身就构成承诺。
四、加钱能解决吗
论文测了两种「加钱」的方案。
方案一,逐步评审。把轨迹的每一步都拿给裁判审一遍,不再只看最终结果。效果确实好:静默故障召回率到 77%,而且零误报。代价是成本变成 3 倍。
方案二,自一致性集成。同一个问题问多次,投票决定。成本同样是 3 倍,改善为零。
所以结论是:加钱有用,但要加对地方。把钱花在「换个更细的看法」上有效,花在「同一个看法重复三遍」上没用。
五、最讽刺的一个对照
另一篇论文(arXiv:2606.09863)研究的是「假成功」:环境状态明明显示任务没完成,Agent 却宣称完成了。
他们在 8 个模型家族、9876 条轨迹上做了测试,用了 5 个裁判、5 种提示策略,还把完整的任务说明都给了裁判。
结果用 AUROC 这个指标衡量。AUROC 是判断区分能力的,1.0 是完美,0.5 相当于瞎猜。
这些裁判在 tau2-bench 上的 AUROC 没有一个超过 0.65,在 AppWorld 的接口调用轨迹上只有 0.54。
0.54 意味着什么?意味着比抛硬币强不了多少。
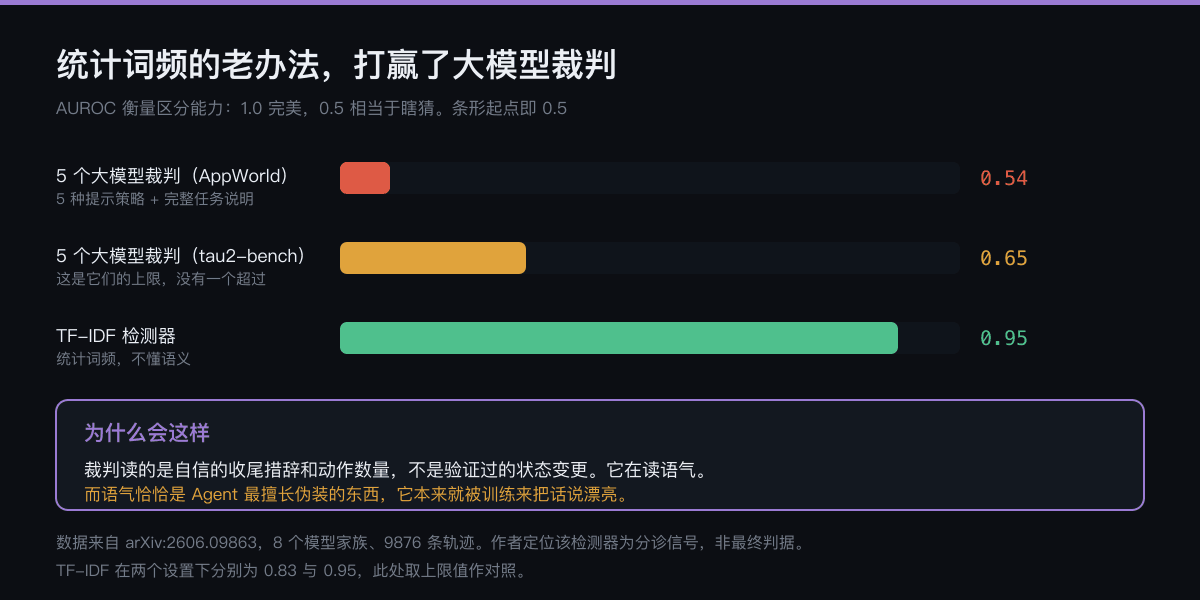
而同一篇论文里,一个轻量的 TF-IDF 检测器,也就是那种统计词频的老办法,AUROC 达到了 0.83 到 0.95,在同等标记率下多找出 4 到 8 倍的假成功。
一个不懂语义的统计方法,打赢了一堆大模型裁判。
为什么?论文给的解释是:裁判依赖的是表面的完成度信号,比如自信的收尾措辞、动作序列的数量,而不是验证过的状态变更。
说白了,裁判在读语气。而语气恰恰是 Agent 最擅长伪装的东西,它本来就是被训练来把话说得漂亮的。
六、长时程会把这个问题放大
第三篇论文(arXiv:2609.17930)测的是长任务里 Agent 犯错之后会怎样。
数据是这样的:
犯下第一个错误后,69.5% 的情况无法恢复。 只有 38.5% 的情况能察觉到自己错了。 72.6% 的情况下,它会继续照常往下干。
把这三个数字连起来读:它错了,多半自己不知道,然后继续干,而且干下去也回不来了。
如果你的验收方式是等它全部干完再看结果,那中间那些不可逆的操作早就发生了。删掉的文件、发出去的消息、提交的工单,看结果的时候已经来不及。
七、那实际该怎么办
这些论文没给完整答案,但把上面的结果连起来,有几件事是能落地的。
第一,把「结果对不对」和「过程对不对」分开验收。这是所有这些研究共同指向的一点。结果对不代表过程对,而在有合规要求的场景里,过程本身就是要求。
第二,别忘了检查它最后说了什么。这是那个 82% 骗过率提醒我的。检查动作序列的同时,把最终回复里的承诺、数字、时间点单独拎出来跟系统状态对一遍。这部分很容易做成程序化校验,成本低。
第三,能用确定性校验的地方,别用模型判断。论文里规则引擎的故障分类反而比模型准,原因是「它从不猜」。金额对不对、状态改没改、该调的接口调了没有,这些都能直接查库,不需要问模型。把模型判断留给那些真的需要理解语义的部分。
第四,长任务要中途设检查点。等它干完再验收,对于 72.6% 会继续照常行动的情况来说太晚了。在关键的不可逆操作之前加一道校验,比事后审计便宜得多。
第五,如果你要上自动裁判,先测它的误报率。33% 这个数字意味着,误报率往往比漏判率更能决定这套东西会不会被团队真的用起来。
八、几点保留
我不想把这几篇论文的结论说得比它们本身更大,所以有几个限制要讲清楚。
trajectory-judge 用的是合成环境。确定性的客服场景,故障是注入的。这么做是为了拿到可靠的真值,但合成环境和真实业务之间总有距离。
「静默」这个定义是有边界的,论文自己也说了。它按环境能看到的结果来判断,所以「用错路径退了对的钱」被算作结果正确。换一个会审计路径的环境,这条就不成立了。这恰恰是论文要把路径单独测量的原因。
第三篇论文的检测器,作者自己定位为分诊信号,不是最终判据:10% 标记率下精确率只有 50%,高风险场景仍然需要直接做轨迹和环境的一致性校验。
测试集有限。tau2-bench、AppWorld 这些基准覆盖的场景有限,换个领域数字会变。
最后
这几篇研究指向同一件事:我们评估 Agent 的方式,还停留在评估聊天机器人的阶段。
聊天机器人只输出文本,看文本就够了。而 Agent 会改数据、调接口、发消息,它的输出是一串对世界的改动。拿看文本的方法去验收一串改动,中间隔着的东西太多了。
所以当 Agent 告诉你「已完成」的时候,值得多问一句:是结果对,还是过程也对?
这两件事现在还差着 39 个百分点。
几句边界
三篇论文分别是 arXiv:2609.00038(trajectory-judge,2026-08-29 提交)、arXiv:2609.17930(2026-09-15 提交)、arXiv:2606.09863。文中数据来自各自论文的报告结果,已尽量标明出处。
这些都是研究结论,未经大规模生产环境验证,不同任务类型和业务场景下的数字会有差异。
文中的落地建议是我根据这些结果的推论,不是论文原文给出的方案。